Las organizaciones optimizadas al límite funcionan de maravilla hasta que algo se va al garete. La resiliencia empresarial empieza por contar con el fallo desde que diseñamos, y eso va mucho más allá de la tecnología. No siempre es todo tecnología.
El 28 de abril de 2025, día oscuro, poco después de las doce y media del mediodía, aprox., se fue la luz en toda la península ibérica. No voy a entrar en las causas del corte, que ya se ha escrito bastante sobre eso, con mucho ruido y pocas conclusiones. Me interesa más lo que pasó en las horas siguientes dentro de las empresas, el caos, los planes ejecutándose, la gente dando vueltas, porque fue un simulacro a escala real que nadie había pedido a su consultor de confianza.
Supongo que muchos lo visteis de cerca si estáis leyendo mi blog. En unas pocas horas quedó claro quién tenía un plan de continuidad que funcionaba y quién tenía un documento chulísimo guardado en una carpeta compartida (a la que, por cierto, sin luz no se podía entrar). También se vio quién sabía trabajar un rato en modo degradado y quién se paraba en seco, porque todo dependía de que todo lo demás funcionara a la vez.
Llevo muchos años trabajando en infraestructuras que no pueden parar nunca, y tengo claro que la eficiencia y la resiliencia en las empresas tiran cada una para un lado. Durante décadas, la gestión empresarial ha premiado la primera, eficacia, y se ha olvidado de que la segunda cuesta dinero y de que en una hoja de cálculo ese dinero nunca tiene ROI, seguro que os suena esta batallita.
El hueco del puzle
Tom DeMarco publicó en 2001 Slack, recomendable si te toca dirigir gente.
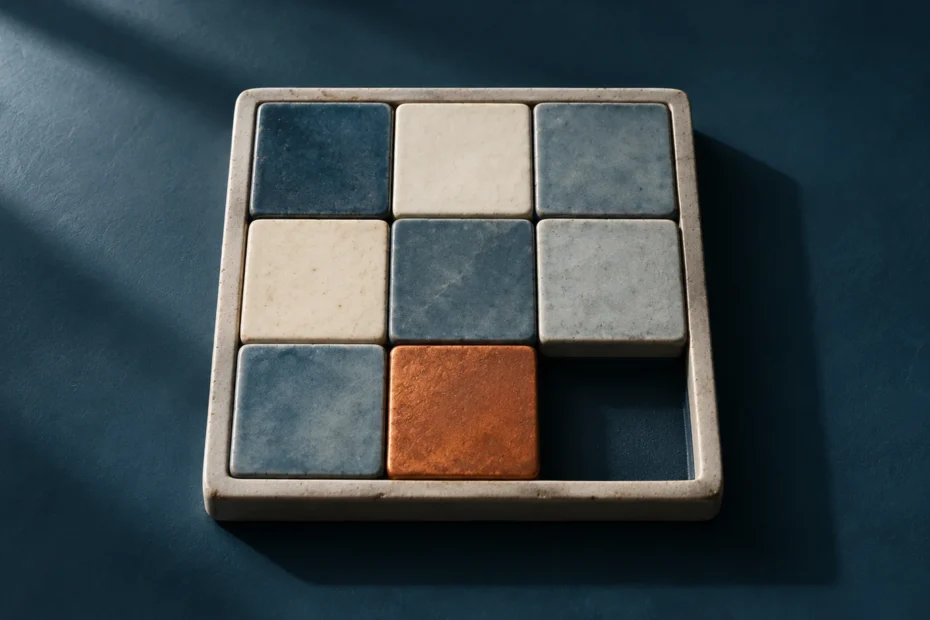
Para explicar la idea, usa un ejemplo simple, el de esos puzles de piezas deslizantes con ocho fichas y un hueco. El hueco es lo que permite mover las piezas de aquí para allá, y si alguien muy eficiente decidiera aprovechar ese espacio metiendo una novena ficha, el puzle quedaría perfecto y completamente inútil, porque ya no se podría mover nada para ningún sitio.
Las organizaciones funcionan igual. Un equipo al 100% de ocupación no tiene hueco para atender un imprevisto, ni margen de reacción, para aprender algo nuevo o para pararse a pensar si lo que está haciendo tiene sentido, mejorar algo o simplemente meditar más allá de la siguiente entrega.
Si has leído algo de teoría de colas, esto es un clásico, cuando la ocupación de un sistema se acerca al 100%, los tiempos de espera crecen de forma desproporcionada, poco intuitiva. Con las personas pasa lo mismo, solo que además se queman; el factor humano no aplica en un sistema.
Lo curioso es que en muchas empresas tener a alguien al 70% se ve como un problema de productividad, cuando ese margen es justo lo que permite que esa persona lo deje todo el día que se cae algo importante, mejore algo, trabaje el pensamiento crítico o mantenga las conexiones dentro d ela emrpesa.
Hasta Toyota guarda chips en el cajón
Si hay una empresa que representa la eficiencia es Toyota, la madre del just in time y de todo eso que luego hemos llamado lean, se ha empaquetado en millones de cursos y podría decirse que es un disciplina.
Después del terremoto y el tsunami de 2011, que paró buena parte de la producción, Los amigos de Toyota se ¿saltaron? sus propios mantras. Puedes ver en Reuters cómo Toyota obligó a sus proveedores a tener almacenados para ella entre dos y seis meses de chips, dependiendo de lo que tardara cada pedido en llegar.
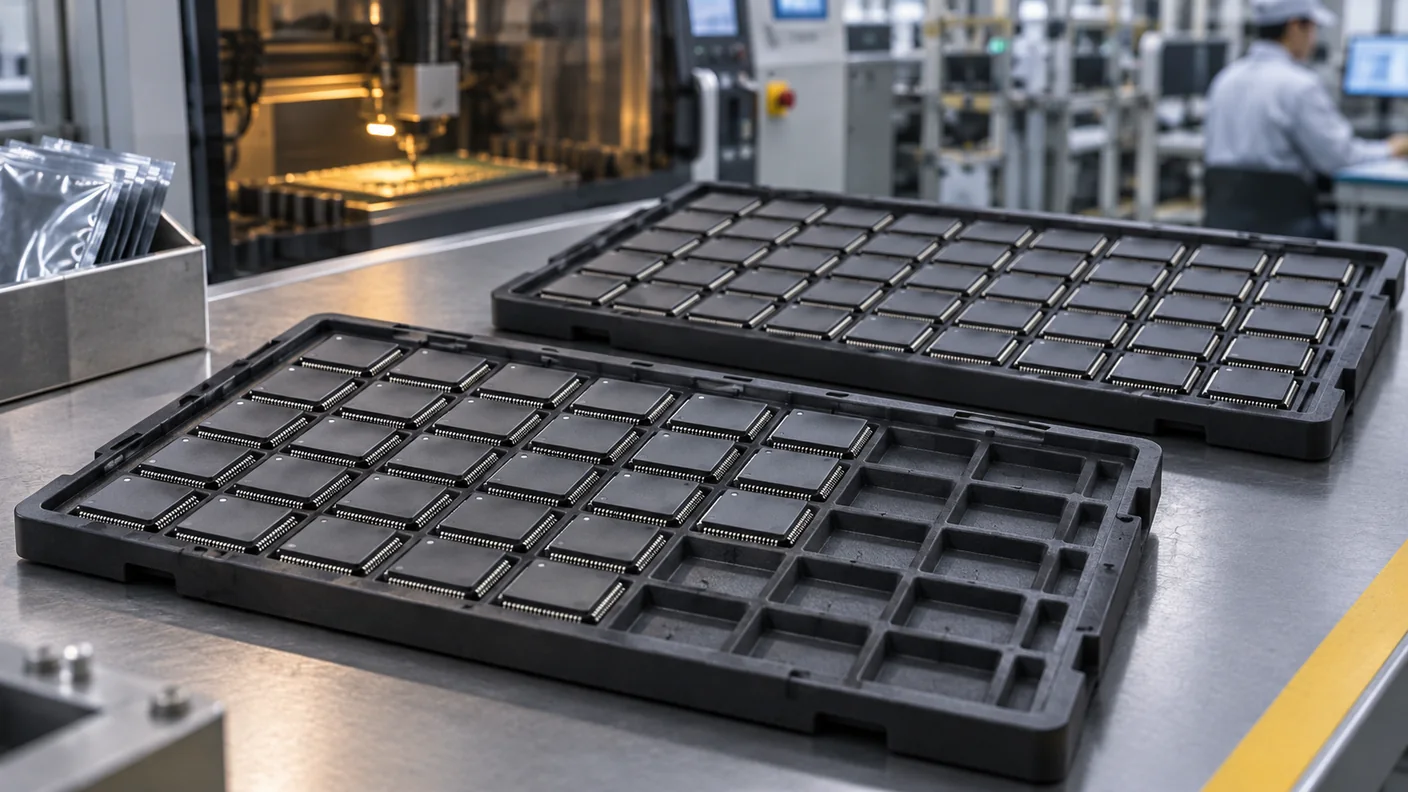
Cuando en 2021 llegó la crisis mundial de semiconductores con todas las movidas del COVID, y demás problemas o síntomas de la cadena de suministro, medio sector del automóvil tuvo que parar líneas. Yo vivo cerca de un núcleo industrial muy ligado al grupo Volkswagen, aqui fue un drama. Sin embargo, Toyota aguantó los primeros meses bastante mejor que la mayoría (llegó incluso a subir su previsión de beneficios). Parecía ir contranatura, pero Toyota lo considera una solución lean de libro, aunque parece lo contrario, porque lo que hizo fue decidir con mucha cabeza qué reservas merecía la pena pagar y cuáles no, que yo creo que es justamente en lo que consiste la resiliencia empresarial.
Just in time para casi todo, y just in case para lo poco que te puede parar la fábrica o tu core de negocio. Es mucho menos vistoso que cualquier gran programa de transformación, pero funciona de maravilla.
Cuando todos usamos lo mismo, caemos a la vez
El 19 de julio de 2024 una actualización defectuosa de CrowdStrike (menudo drama), una de las herramientas de seguridad para puestos de trabajo más extendidas del mundo, dejó colgados unos 8,5 millones de equipos con Windows, según los datos de Microsoft. Aerolíneas que tuvieron que dejar los aviones en tierra, bancos, comercios, redes de trenes y multitud de sistemas críticos… Fue menos del 1% de los equipos con Windows del planeta, pero era justo el 1% que hacía funcionar cosas importantes, CrowdStrike no es para todos, suelen ter un target muy Enterprise pro.
Más allá del error de un proveedor de ciber, lo que se vio ese día es el precio de que todos usemos lo mismo, de la misma manera. Estandarizar tiene muchísimas ventajas, y lo digo como alguien que siempre ha defendido reducir el número de tecnologías distintas en una empresa (cuantas menos piezas diferentes, menos hay que mantener y proteger y conocer).
Pero tiene una cara B. Cuando todo el mundo usa la misma pieza, un fallo en esa pieza deja de ser un problema de uno y pasa a ser un problema de todos, y además a la vez. Un claro objetivo.
En agricultura a esto se le llama monocultivo, y los agricultores saben desde hace mucho lo que le pasa a un campo en el que todas las plantas son iguales cuando llega una plaga. Tener tres antivirus para dormir tranquilo sería un disparate. Lo sensato es saber qué piezas te paran todo si fallan, y tener pensado, y entrenado qué hacer cuando fallen.
El que no se puede ir de vacaciones
Hay un tipo de punto único de fallo que no aparece en ningún diagrama, y es la persona imprescindible. Todos conocemos a alguien así, el único que sabe cómo funciona tal integración, el que tiene las contraseñas de aquel sistema antiguo o el que entiende cómo se cierra un proceso crítico, afortunadamente creo que cada vez menos, pero todavia es común.
Suele ser alguien muy bueno y muy eficiente, y precisamente por eso nadie se ha preocupado nunca de que otro sepa hacer lo mismo (si mientras leéis esto estáis pensando en alguien concreto, ya sabéis de qué hablo).
Hay una prueba muy sencilla para detectarlo. Si alguien no se puede ir dos semanas de vacaciones sin que haya que llamarle o escribirle, la empresa tiene un problema serio, y ese problema no es de esa persona eficiente desde luego.
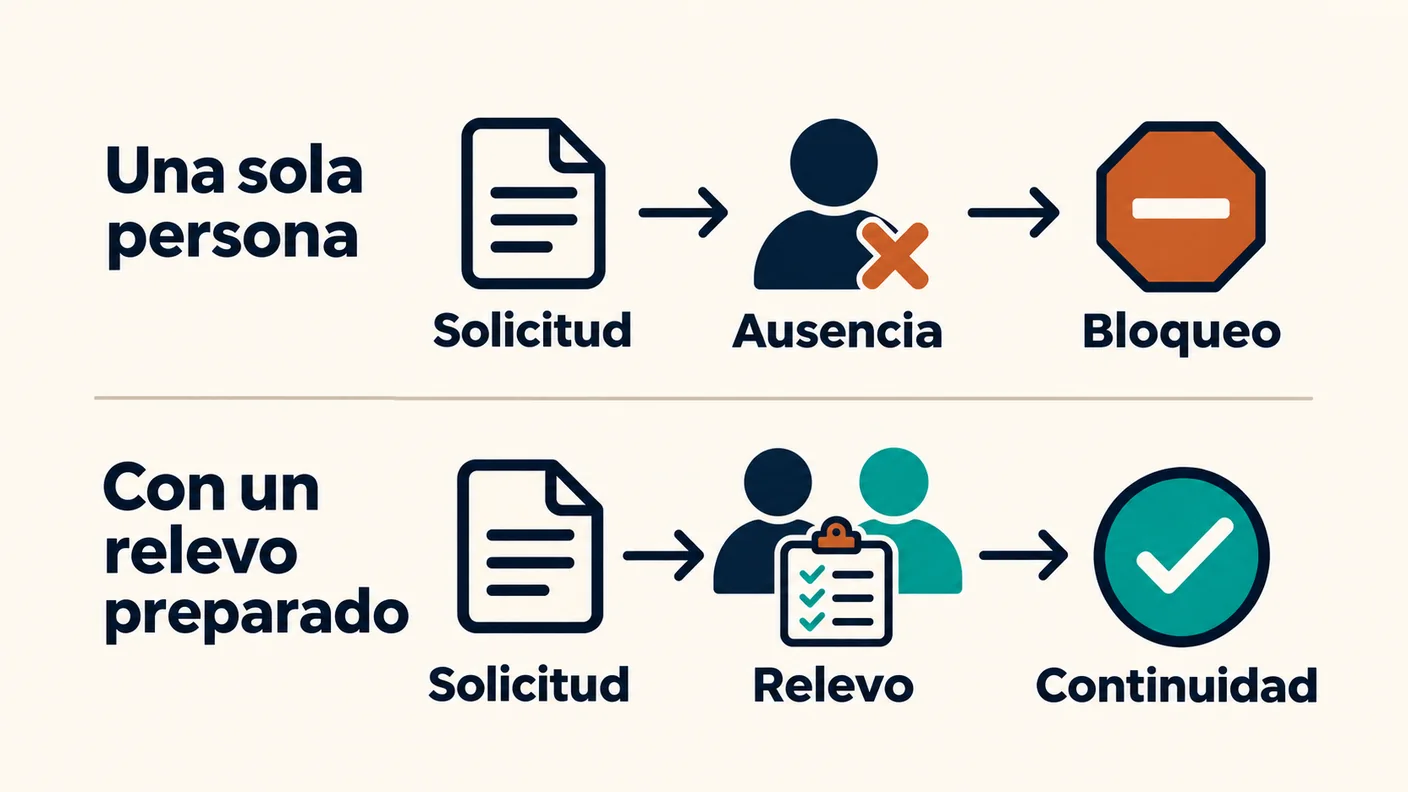
Repartir el conocimiento cuesta tiempo, esfuerzo, documentación y alguna rotación, y en el día a día parece ineficiente, parece que no aporta, porque de repente hay dos personas que saben hacer lo que antes hacía una. Pero es la única forma de que la empresa siga funcionando si esa persona se pone mala, cambia de trabajo, le toca la lotería o simplemente se jubila.
Diseñar contando con que algo va a fallar
En ingeniería esto lo tenemos bastante interiorizado, es un defecto profesional aprendido a base de palos. Hablamos de redundancia N+1, de evitar puntos únicos de fallo, de degradación controlada y de probar las copias de seguridad en lugar de suponer que funcionan bien. Diseñamos sabiendo que los discos se rompen, que las líneas se caen y que los proveedores fallan, por lo menos a mi me resulta en ocasiones complicado explicarlo, habitualmente nadie fuera de nuestro ámbito da la mas mínima importancia a esto, y muchas veces lo ve como un stopper.
Me llama la atención es lo poco que esa forma de pensar sale del departamento de sistemas, cuando la resiliencia empresarial depende de todo lo demás, es muy curioso.
Hay muchas empresas con un único proveedor para algo crítico porque era el más barato, o nos caía bien, con procesos que se paran si una sola persona no firma algo, o con planes de continuidad que nunca se han ensayado con la gente que tendría que ejecutarlos. Un plan de continuidad que no se ha probado nunca es, como mucho, una hipótesis con buena maquetación y una portada chula.
Mi recomendación es empezar por algo tan sencillo como preguntarse, área por área, qué pasaría si mañana falla esto. No hace falta un gran proyecto ni una consultora (aunque el comercial de turno os diga lo contrario).
Hace falta sentarse con la gente que hace el trabajo, hacer un análisis de riesgos honesto y decidir dónde merece la pena pagar holgura y dónde no. Ya lo decía aquí hace unos años y sigo pensando igual, hay que invertir donde de verdad duele, que casi nunca coincide con lo que más brilla en una feria.
La resiliencia empresarial tiene un problema de imagen
Se paga por adelantado, no luce en ninguna presentación y, cuando funciona, no pasa nada, así que nadie se acuerda de agradecerla. Es muy difícil defender en un comité de dirección que una parte del presupuesto de este año va a algo que, con suerte, no se usará nunca.
No tiene buen marketing, no es vendible ni bonito, pero creo que esa es justo una de las responsabilidades de quien dirige bien, sea en tecnología o en cualquier otra área. Decidir cuánta eficiencia estás dispuesto a sacrificar a cambio de no caerte entero el día que algo falle, porque algo va a fallar amigo, no lo dudes. El apagón, CrowdStrike o la persona que se va sin avisar son solo los ejemplos que todos tenemos frescos.
Al final, la pregunta que me hago con cualquier sistema o proceso (y cada vez más con cualquier equipo) es siempre la misma, qué pasa si mañana esto falla. Si la respuesta es «nada grave», enhorabuena. Si la respuesta es un silencio incómodo o un «ya veremos», ya sabéis por dónde empezar.